Agents IA hybrides : raisonner en latent, agir en texte - rupture 2026
Du texte au latent : ce que la recherche 2025 change concrètement en 2026
Pendant des années, le paradigme dominant des grands modèles de langage reposait sur une équation simple : raisonner, c'est générer des tokens. Chaque étape de réflexion d'un agent passait par la production de texte visible, mot après mot, avec le coût computationnel que cela implique. Ce modèle a montré ses limites dès lors que les chaînes de raisonnement s'allongent et que les déploiements en production atteignent une échelle industrielle.
Les travaux de recherche publiés sur arXiv (arxiv.org/abs/2610.18861) décrivent une rupture architecturale : des agents LLM capables de penser en espace latent - c'est-à-dire dans l'espace des représentations internes continues du modèle - tout en continuant à agir via du texte pour communiquer avec l'extérieur. Ce découplage entre raisonnement interne et communication externe n'est pas un détail d'implémentation. C'est un changement de paradigme.
Le raisonnement en espace latent permet des chaînes de pensée plus riches sans le coût de la génération token par token. L'agent réfléchit en continu, puis traduit uniquement ce qui est nécessaire en langage naturel.
En 2025, ces architectures relevaient encore du laboratoire. En 2026, elles commencent à irriguer les frameworks d'agents en production. Pour les DSI et CTO, la question n'est plus théorique : elle est opérationnelle.
| Paradigme | Raisonnement | Communication | Coût computationnel |
|---|---|---|---|
| Agent textuel classique | Génération token par token | Texte visible | Élevé à chaque étape |
| Agent hybride latent | Espace de représentations internes | Texte généré à la sortie | Réduit sur les étapes intermédiaires |
Implications architecturales : ce que les équipes techniques doivent anticiper
Pour un DSI ou un CTO qui déploie des agents en production, cette évolution soulève trois questions pratiques immédiates.
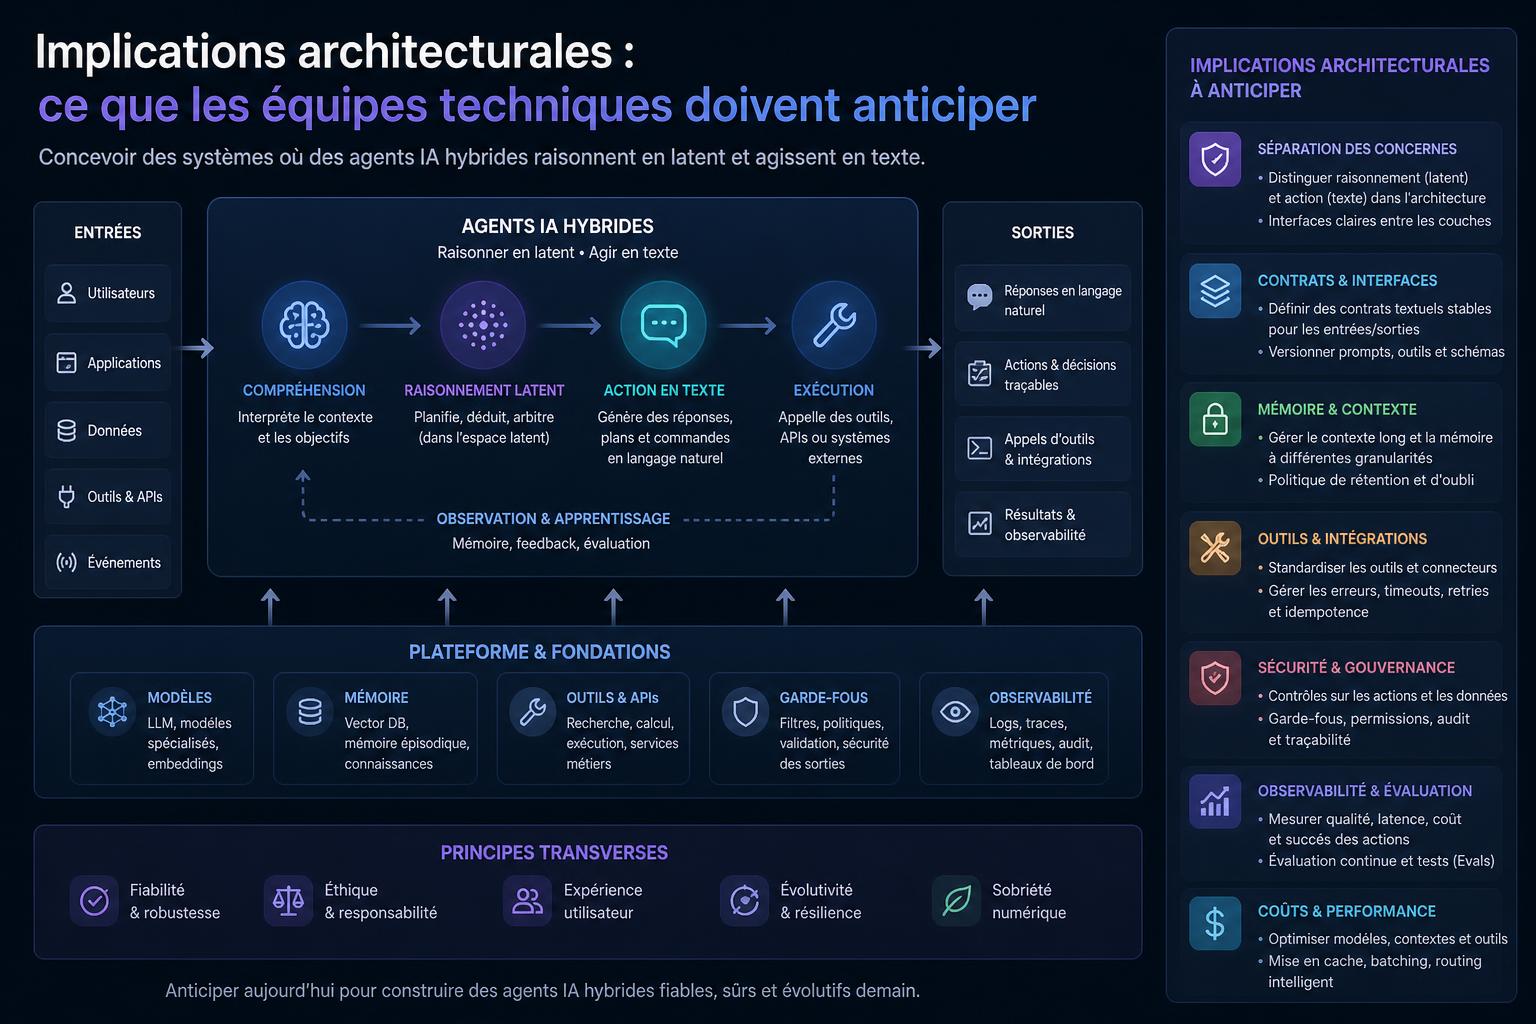
- Performance et latence : un agent qui raisonne en espace latent n'a pas besoin de matérialiser chaque étape intermédiaire en texte. Les gains de vitesse peuvent être substantiels sur des pipelines d'agents multi-étapes, notamment dans les cas d'usage où la chaîne de raisonnement est longue (analyse de documents complexes, orchestration multi-outils, planification de tâches).
- Coût d'inférence : la facturation des API LLM repose aujourd'hui sur le nombre de tokens générés. Un raisonnement partiellement conduit en espace latent réduit mécaniquement le volume de tokens produits, donc la facture. À l'échelle d'un déploiement industriel, l'impact budgétaire peut être significatif.
- Observabilité et gouvernance : c'est ici que la rupture devient un défi. Si l'agent pense en interne sans produire de trace textuelle intermédiaire, comment auditer son raisonnement ? Comment détecter une dérive ou un comportement inattendu ?
Ce dernier point rejoint directement les enjeux soulevés par l'article pratique disponible sur jrdsgl.com/if-you-dont-run-your-own-llm-proxy-how-the-fuck-do-you-even-know-whats-going-on/ : sans proxy LLM maîtrisé, sans couche d'observabilité propre, les équipes opèrent à l'aveugle. Avec des agents hybrides, cette opacité s'accroît encore, car une partie du raisonnement n'est plus capturée dans les logs de tokens.
Si vous ne faites pas tourner votre propre proxy LLM, comment savez-vous réellement ce qui se passe dans vos appels aux modèles ? Latences, coûts réels, prompts effectifs, comportements inattendus : tout cela vous échappe.
La convergence entre ces deux sources est frappante : d'un côté, la recherche pousse vers plus d'internalisation du raisonnement ; de l'autre, les praticiens alertent sur le déficit d'observabilité déjà présent avec les agents purement textuels. Les architectures hybrides amplifient ce besoin de gouvernance plutôt qu'elles ne le résolvent.
Ce que les décideurs tech doivent mettre en place dès maintenant
Face à cette rupture architecturale, l'attentisme est une stratégie risquée. Voici les actions concrètes à engager en 2026 pour ne pas subir la transition.
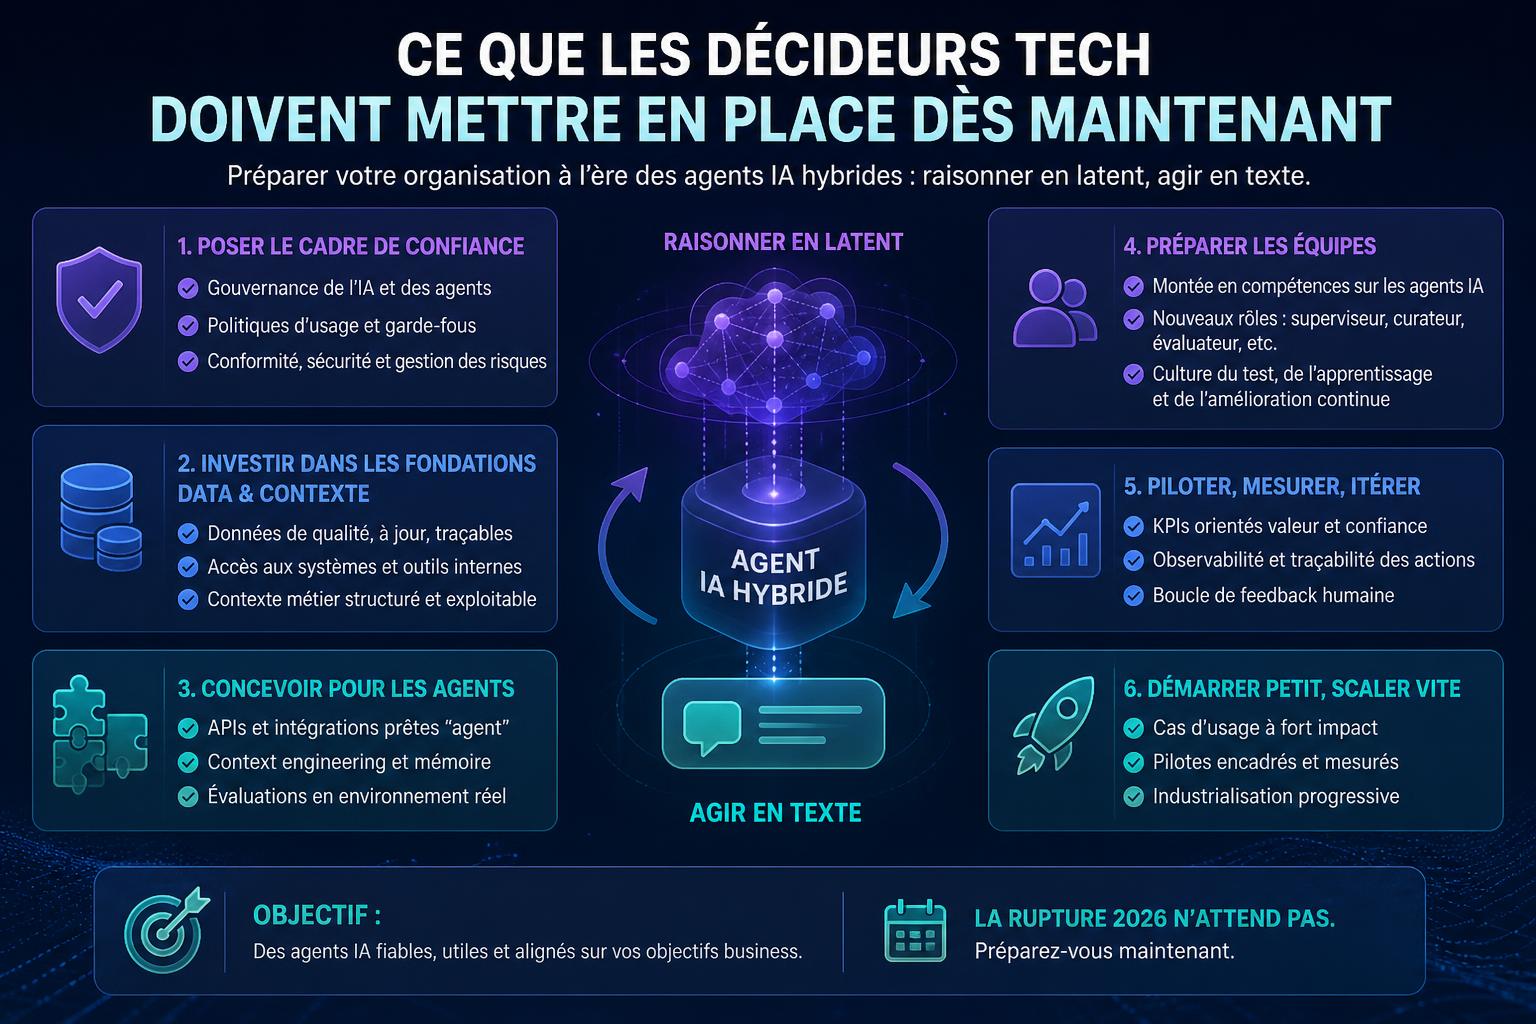
- Déployer un proxy LLM interne : c'est la fondation. Avant même d'adopter des agents hybrides, toute organisation qui appelle des LLM en production doit instrumentaliser ces appels. Un proxy maîtrisé capture les prompts réels, les latences, les coûts et les anomalies. C'est la condition minimale pour gouverner un parc d'agents.
- Exiger des traces de raisonnement explicites : lors de l'évaluation de frameworks d'agents hybrides, demander systématiquement quelles traces sont exposées. Un agent qui pense en latent doit quand même produire des artefacts d'audit - même synthétiques - pour permettre le débogage et la conformité réglementaire.
- Benchmarker le ratio coût/qualité : les gains de performance des architectures latentes ne sont pas uniformes selon les tâches. Certains cas d'usage (raisonnement symbolique, planification longue) bénéficient davantage que d'autres (génération créative, dialogue simple). Construire des benchmarks internes avant de migrer.
- Former les équipes à la nouvelle sémantique : les développeurs habitués à lire des chaînes de pensée textuelles (style chain-of-thought) doivent adapter leurs pratiques de débogage. Le raisonnement latent n'est pas lisible directement : il faut de nouveaux outils d'interprétabilité.
En synthèse, 2026 marque le début d'une période de transition où les équipes les mieux préparées sont celles qui ont déjà investi dans l'observabilité de leurs agents textuels classiques. Elles disposent de la maturité opérationnelle pour absorber la complexité supplémentaire des architectures hybrides. Les autres devront rattraper deux retards simultanément.
Pour aller plus loin
Un projet IA dans votre entreprise ?
Algomind, agence IA basée à Annecy, construit des automatisations, des agents IA et des logiciels sur mesure, et forme vos équipes, en Savoie, Haute-Savoie, à Genève et à Lyon.