GPT, Claude, Grok au volant : un seul passe le test en 2026
Le test grandeur nature qui bouscule les certitudes
En 2026, trois ingénieurs ont décidé de pousser l'expérience au-delà des benchmarks habituels. Ils ont placé GPT, Claude et Grok aux commandes d'une Toyota Corolla réelle, avec une mission simple en apparence : conduire jusqu'à un fast-food In-N-Out. Pas de simulateur, pas d'environnement contrôlé. Une vraie route, un vrai véhicule, des risques physiques concrets.
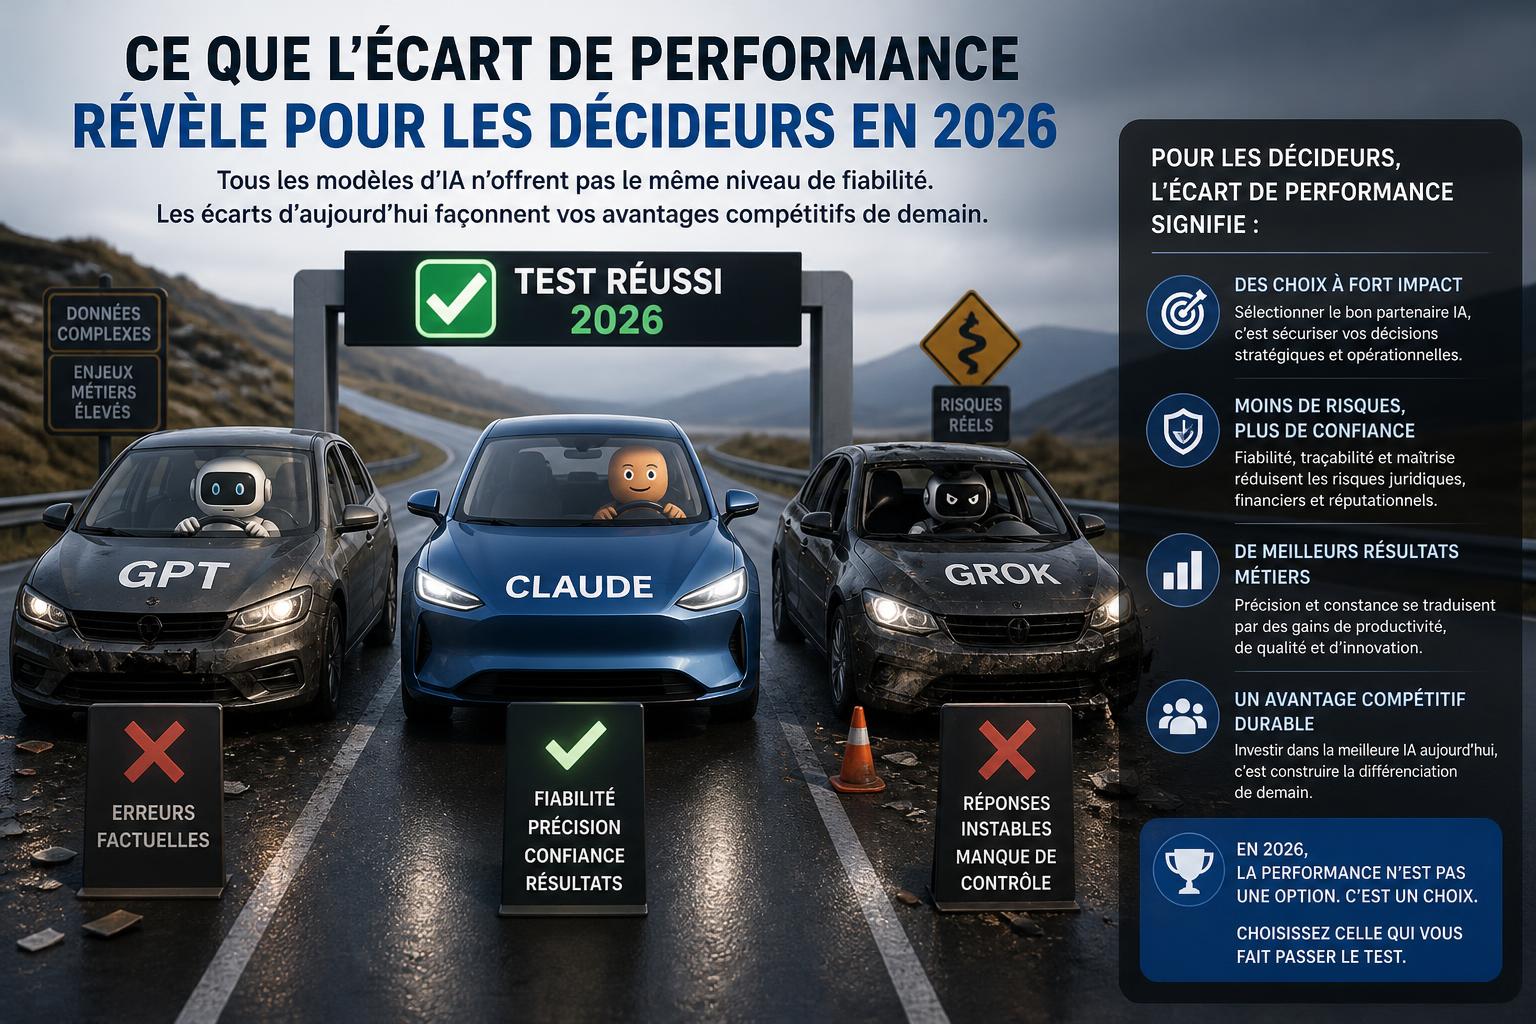
Le résultat, relayé par Wired (wired.com/story/ai-is-driving-cars-now-oh-boy), est sans appel : un seul des trois modèles a accompli la mission. Les deux autres ont échoué, révélant des écarts de performance qui dépassent largement ce que les classements académiques laissent entrevoir.
Un seul LLM généraliste sur trois a réussi à conduire une voiture réelle jusqu'à destination - un résultat qui remet en question l'idée que les grands modèles de langage sont interchangeables pour des tâches à enjeux élevés.
Ce type d'essai tranche avec les évaluations classiques. Ici, pas de QCM, pas de génération de texte : le modèle doit percevoir un environnement, prendre des décisions séquentielles, gérer l'incertitude physique et ne pas commettre d'erreur irréversible. C'est précisément ce que les décideurs tech cherchent à comprendre lorsqu'ils envisagent d'intégrer des agents IA dans des systèmes réels.
Ce que l'écart de performance révèle pour les décideurs en 2026
L'expérience n'est pas anodine sur le plan stratégique. Elle illustre une réalité que beaucoup d'équipes tech découvrent en 2026 après avoir surinvesti dans l'idée que les LLM généralistes sont des couteaux suisses universels : la performance dans un domaine textuel ne prédit pas la fiabilité dans un contexte physique, séquentiel et critique.
| Critère évalué | Contexte textuel classique | Conduite autonome réelle |
|---|---|---|
| Tolérance à l'erreur | Haute - une mauvaise réponse se corrige | Très faible - une erreur peut être irréversible |
| Gestion de l'incertitude | Modérée | Critique et continue |
| Décisions séquentielles | Peu contraignantes | Enchaînées et dépendantes |
| Feedback environnemental | Absent ou simulé | Réel et dynamique |
Pour les équipes qui évaluent l'intégration d'agents IA dans des workflows à enjeux élevés - logistique, santé, infrastructure industrielle - ce test pose une question directe : quel modèle choisir quand l'échec a des conséquences concrètes ?
- La réputation sur les benchmarks ne suffit pas. Un modèle dominant sur les tests académiques peut s'effondrer face à des contraintes physiques et temporelles réelles.
- L'architecture d'intégration compte autant que le modèle. La façon dont le LLM reçoit les données sensorielles et traduit ses décisions en actions est déterminante.
- Les écarts entre modèles sont plus larges qu'anticipé. En 2025, beaucoup de décideurs traitaient GPT, Claude et Grok comme des alternatives quasi-équivalentes. Ce test de 2026 invalide cette hypothèse pour les cas d'usage critiques.
Ce que le bilan 2025 change en 2026, c'est la posture d'évaluation. Les entreprises qui se contentaient de comparer les prix et les quotas d'API doivent désormais intégrer des protocoles de test en conditions réelles avant tout déploiement à risque. L'ère du copier-coller de modèles entre cas d'usage est terminée.
L'expérience complète est détaillée sur Wired : wired.com/story/ai-is-driving-cars-now-oh-boy
Pour aller plus loin
Un projet IA dans votre entreprise ?
Algomind, agence IA basée à Annecy, construit des automatisations, des agents IA et des logiciels sur mesure, et forme vos équipes, en Savoie, Haute-Savoie, à Genève et à Lyon.


